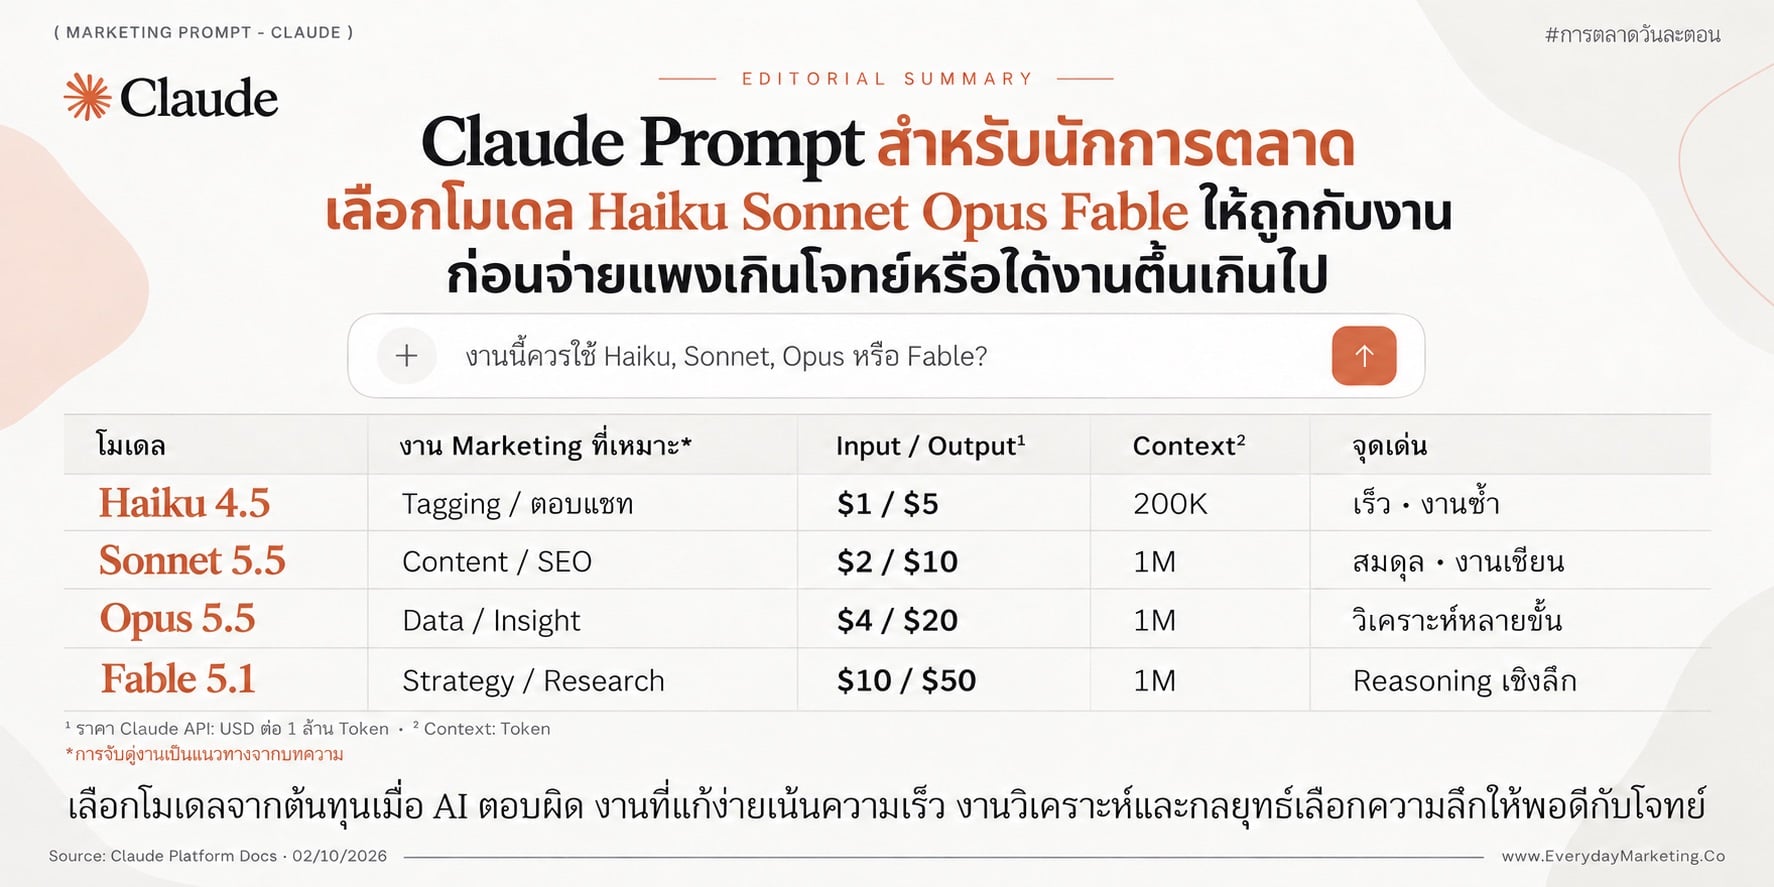
รู้มั้ยครับว่าโมเดล Claude ตัวถูกสุดกับตัวแพงสุดที่เปิดให้ใช้ตอนนี้ ราคา Token ต่างกันถึง 10 เท่า ตามหน้าภาพรวมโมเดลของ Claude Platform Haiku 4.5 อยู่ที่ 1 ดอลลาร์ต่อ Input 1 ล้าน Token ส่วน Fable 5.1 อยู่ที่ 10 ดอลลาร์ และฝั่ง Output ก็ห่างกัน 10 เท่าเหมือนกันคือ 5 ดอลลาร์เทียบกับ 50 ดอลลาร์
ตัวเลขนี้ไม่ได้แปลว่าตัวแพงดีกว่าตัวถูก 10 เท่าในทุกงาน และไม่ได้แปลว่าตัวถูกใช้แทนตัวแพงได้ทุกงานเช่นกัน แต่แปลว่าถ้าเราใช้โมเดลผิดตัว เราจะเสียอย่างใดอย่างหนึ่งเสมอ คือเสียเงินเกินโจทย์ หรือเสียคุณภาพงานที่ควรจะได้ครับ
จากที่ผมสังเกตพบว่าคนส่วนใหญ่เลือกโมเดล Claude ด้วยความเคยชิน บางคนกดตัวบนสุดตลอดเพราะคิดว่าแพงสุดคือดีสุด บางคนใช้ตัวที่เปิดมาเป็น Default ไปตลอดโดยไม่เคยสลับเลย ทั้งสองแบบมีต้นทุนที่มองไม่เห็นเหมือนกัน แบบแรกคือจ่ายค่าตัว Senior ไปทำงานง่ายๆ อย่างนั่งติด Tag โพสต์ หรือให้ Junior ไปวาง Brand Strategy
บทความนี้ผมเลยอยากชวนเพื่อนๆ นักการตลาดมาถอดรหัสว่าโมเดล Claude ทั้ง 4 ตัว คือ Haiku, Sonnet, Opus และ Fable ต่างกันตรงไหนสำหรับนักการตลาด งานไหนควรใช้ตัวไหน และถ้าให้บรีฟเดียวกันกับทั้ง 4 ตัว คำตอบจะต่างกันยังไง ซึ่งบทความนี้เป็นตอนแรกของซีรีส์ Claude Prompt สำหรับนักการตลาด ที่จะแยกลงรายละเอียดทีละงานในตอนถัดๆ ไปครับ
The Four Models รู้จักโมเดล Claude ทั้ง 4 ตัวในมุมของนักการตลาด ไม่ใช่มุมของวิศวกร
ก่อนจะไปถึงเรื่องเลือกโมเดล ต้องเข้าใจก่อนว่าทั้ง 4 ตัวถูกออกแบบมาให้ต่างกันตรงไหน ซึ่งผมขอสรุปแบบที่คนทำงานการตลาดเห็นภาพทันที ไม่ต้องไปอ่าน Benchmark ให้ปวดหัว
Haiku 4.5 คือตัวเร็วสุดและถูกสุด ความฉลาดอยู่ในระดับใกล้ Frontier ตามที่ Anthropic ระบุเอง แต่มีข้อจำกัด 2 อย่างที่นักการตลาดต้องรู้ คือ Context Window อยู่ที่ 200,000 Token ซึ่งเล็กกว่าอีก 3 ตัวที่ให้ 1 ล้าน Token และ Knowledge Cutoff อยู่ที่กุมภาพันธ์ 2025 ซึ่งเก่ากว่าตัวอื่นที่อัปเดตถึงมิถุนายน 2026 ดังนั้นอย่าใช้ Haiku ถามเรื่องที่ต้องรู้โลกปัจจุบัน ให้ใช้กับงานที่เราป้อน Data ให้มันประมวลผลเท่านั้นครับ
Sonnet 5.5 คือตัวที่ Anthropic วางไว้ว่าเป็นสมดุลที่ดีสุดระหว่างความเร็วกับความฉลาด ราคา 2 ดอลลาร์ต่อ Input 1 ล้าน Token และ 10 ดอลลาร์ต่อ Output ได้ Context 1 ล้าน Token เท่าตัวบน ซึ่งทำให้โยน Report ทั้งเล่มหรือ Spreadsheet ทั้งไฟล์เข้าไปได้สบาย เป็นโมเดลสำหรับงานประจำวันของนักการตลาดในความเห็นผม
Opus 5.5 คือตัวที่ Anthropic แนะนำให้เริ่มต้นสำหรับงานส่วนใหญ่ ราคา 4 ดอลลาร์ต่อ Input และ 20 ดอลลาร์ต่อ Output จุดเด่นที่เอกสารทางการเน้นคือการทำงานแบบ Agentic ต่อเนื่องได้นาน หมายถึงงานที่ต้องอ่านหลายไฟล์ วิเคราะห์ ทำกราฟ แล้วเขียนสรุปในงานเดียวโดยไม่หลุดกลางทาง
Fable 5.1 คือตัวบนสุดที่เปิดให้ใช้ทั่วไป ราคา 10 ดอลลาร์ต่อ Input และ 50 ดอลลาร์ต่อ Output ออกแบบมาสำหรับงาน Reasoning ที่หนักและงาน Agentic ที่ลากยาวหลายสิบขั้นตอน เอกสารของ Anthropic เขียนไว้ชัดว่าให้ขยับมาใช้ Fable เมื่อ Opus 5.5 ที่เปิด Effort สูงแล้วยังตอบโจทย์ไม่ได้ แปลว่า Fable ไม่ใช่ Default แต่คือตัวที่เรียกมาเฉพาะโจทย์ใหญ่ครับ
ถ้าให้เทียบเป็นทีม Agency ก็คือ Haiku เป็น AE จูเนียร์ที่ทำงาน Routine เร็วมาก Sonnet เป็น Content Lead ที่รับบรีฟแล้วส่งงานได้เลย Opus เป็น Insight Director ที่นั่งวิเคราะห์ได้ทั้งวันไม่เหนื่อย และ Fable เป็น Strategic Planner ระดับ Partner ที่ค่าตัวแพง คิดนาน แต่คิดได้ลึกกว่าใคร
The Cost of Being Wrong หลักคิดเดียวที่ใช้เลือกโมเดล Claude ได้ทุกงาน
เล่าถึงตรงนี้หลายคนน่าจะเริ่มถามว่า แล้วจะรู้ได้ยังไงว่างานตรงหน้าควรใช้ตัวไหน ผมมีหลักคิดเดียวที่ใช้มาตลอดคือถามตัวเองว่า ถ้า AI ตอบผิด ราคาของความผิดพลาดนั้นคือเท่าไหร่
งานที่ผิดแล้วแก้ง่าย เช่น Caption ที่เขียนใหม่ได้ใน 10 วินาที หรือ Draft แรกของบทความที่ยังไงก็ต้องรื้ออยู่แล้ว ให้ใช้ตัวที่เร็วและถูก เพราะมูลค่าของความเร็วในการ Iterate สูงกว่ามูลค่าของความลึกในรอบแรก
งานที่ผิดแล้วทีมต้องรื้อใหม่ทั้งชุด เช่น Insight Summary ที่จะส่งลูกค้า หรือ Data ที่จะเอาไปตัดสินใจย้ายงบ ให้ใช้ตัวที่คิดลึกกว่า เพราะค่าโมเดลที่เพิ่มขึ้นไม่กี่สิบบาทต่องาน ถูกกว่าค่าแก้งานของทีมทั้งวันหลายเท่า
ส่วนงานที่ผิดแล้วแพงที่สุด เช่น Brand Strategy หรือ Positioning ที่จะใช้ไปอีก 3 ปี ให้ใช้ตัวบนสุดโดยไม่ต้องคิดมากครับ ค่าโมเดลที่แพงกว่า 10 เท่าในวันนี้ ถูกกว่าการวางแบรนด์ผิดทางที่รู้ตัวอีกทีตอนยอดขายปีหน้าไม่มาอย่างเทียบกันไม่ได้
ผมขอยอมรับก่อนว่าตัวเองก็เคยทำตรงข้ามกับหลักคิดนี้มาก่อน ช่วงแรกที่โมเดลหลายระดับออกมา ผมกดตัวแพงสุดกับทุกงานด้วยความคิดว่าได้ของดีสุดไว้ก่อน จนวันหนึ่งนั่งดูงานที่ให้ AI ทำย้อนหลัง แล้วพบว่างานส่วนใหญ่คืองานที่ Sonnet ทำได้ไม่ต่างกัน และความช้าของตัวแพงกลับทำให้ผมลอง Prompt น้อยรอบลงด้วยซ้ำ ซึ่งจำนวนรอบที่ลองนี่แหละที่มักทำให้งานดีขึ้นมากกว่าโมเดลที่ใช้
พอได้หลักคิดเรื่องราคาของความผิดพลาดแล้ว คำถามถัดไปที่นักการตลาดอย่างเราน่าจะอยากเห็นกับตาคือ แล้วถ้าให้โจทย์เดียวกันกับทั้ง 4 ตัวจริงๆ คำตอบจะต่างกันขนาดไหน ซึ่งผมลองทำให้ดูในส่วนถัดไปครับ
The Same Brief Test ให้บรีฟเดียวกันกับ Claude ทั้ง 4 ตัว แล้วดูว่าใครตอบแบบไหน
บรีฟที่ผมใช้ทดสอบเป็นโจทย์กลางๆ ที่ธุรกิจส่วนใหญ่เจอ ไม่ผูกกับแบรนด์ไหน เพื่อให้เห็นความต่างของวิธีคิดของแต่ละโมเดลชัดที่สุด และต้องบอกไว้ตรงนี้ว่าผลลัพธ์ที่สรุปด้านล่างเป็นตัวอย่างประกอบที่ผมเรียบเรียงให้เห็นลักษณะคำตอบของแต่ละตัว ไม่ใช่การก๊อปคำตอบมาวางทั้งหมด เพราะของจริงยาวกว่านี้หลายเท่า และคำตอบจริงจะเปลี่ยนไปตาม Prompt ของแต่ละคนครับ
ผมทำร้านเบเกอรี่โฮมเมดเล็กๆ มี 1 สาขา ยอดขายหน้าร้านยังดี
แต่ยอดสั่งผ่าน LINE OA ตกลง 30% ในช่วง 3 เดือนที่ผ่านมา
ช่วยคิดให้หน่อยว่าควรทำอะไรต่อ
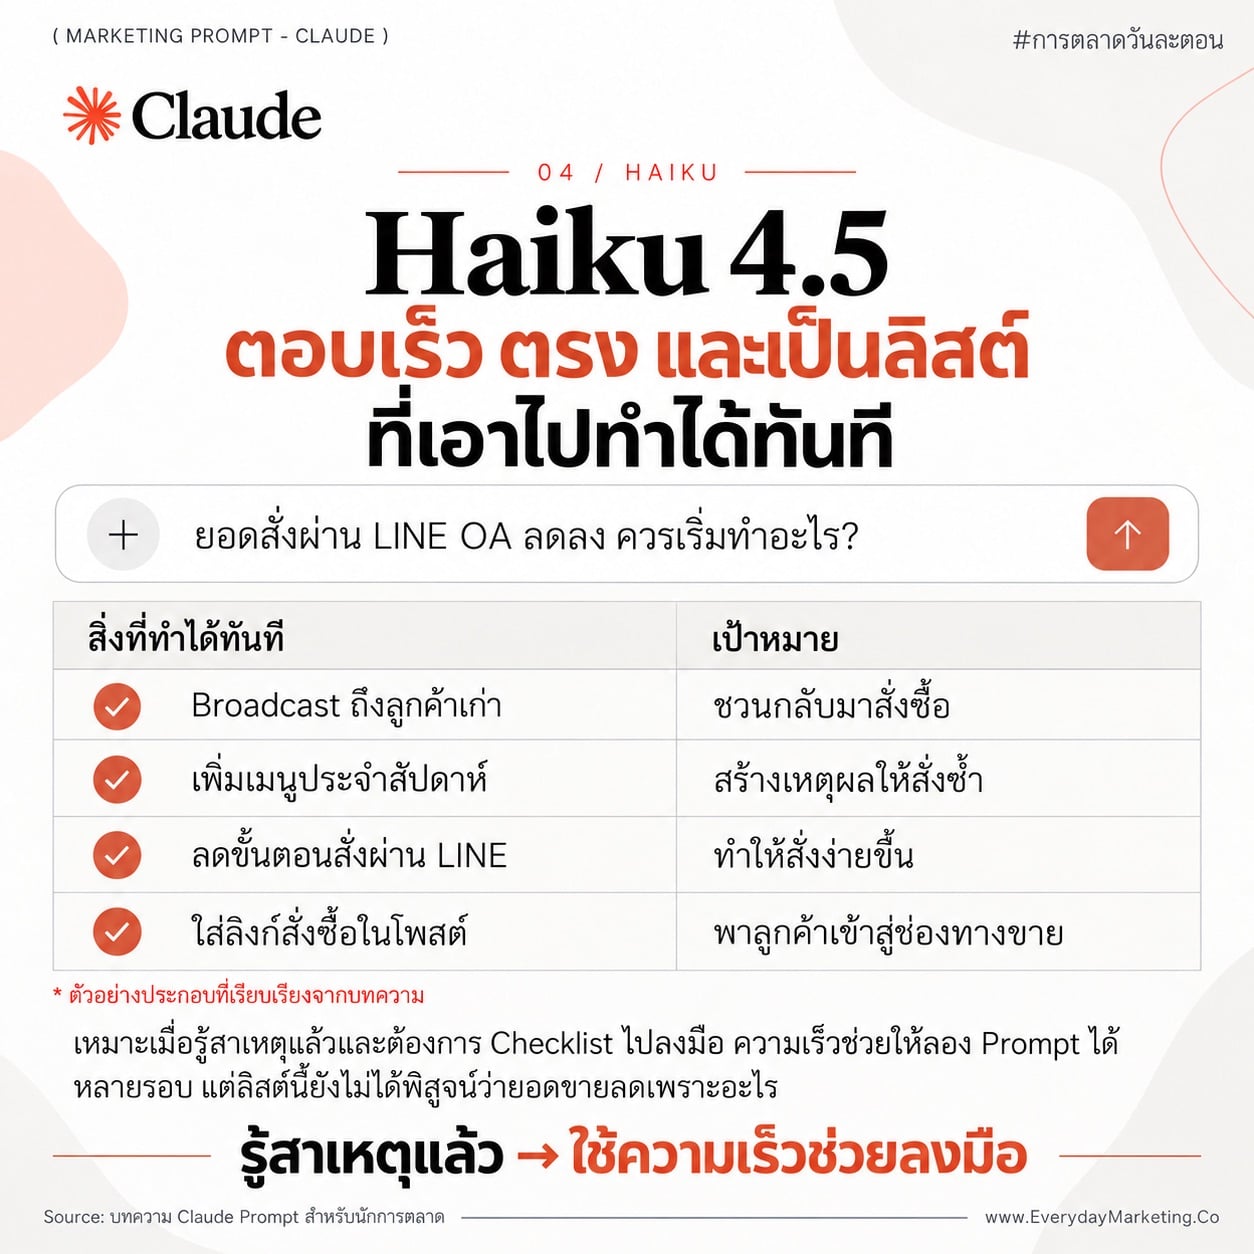
Haiku 4.5 ตอบเร็ว ตรง และเป็นลิสต์ที่เอาไปทำได้ทันที
Haiku ตอบกลับมาภายในไม่กี่วินาทีเป็นรายการสิ่งที่ควรทำ 5 ถึง 6 ข้อ เช่น ส่ง Broadcast โปรโมชันกลับไปหาลูกค้าเก่า เพิ่มเมนูใหม่ประจำสัปดาห์เพื่อให้มีเหตุผลสั่งซ้ำ ลดขั้นตอนการสั่งใน LINE ให้สั้นลง และใส่ลิงก์สั่งซื้อในทุกโพสต์หน้าร้าน
ลักษณะคำตอบคือครบ ใช้ได้ แต่ไม่ได้ถามกลับว่าทำไมยอดถึงตก คำตอบนี้เหมาะกับคนที่รู้สาเหตุอยู่แล้วและต้องการ Checklist ไปลงมือ ซึ่งนี่คือจุดแข็งของ Haiku ที่หลายคนมองข้าม คือความเร็วที่ทำให้เราไม่เสียจังหวะการทำงาน
Sonnet 5.5 ตอบเป็นแผนที่มีโครง พร้อมตัวอย่างข้อความให้ใช้
Sonnet ไม่ได้ให้แค่ลิสต์ แต่จัดเป็นแผน 3 ช่วง คือหาสาเหตุใน 1 สัปดาห์แรกด้วยการดู Data ง่ายๆ 3 ตัวว่าคนเปิดแชทน้อยลง สั่งน้อยลง หรือสั่งแล้วยกเลิกมากขึ้น จากนั้นเป็นช่วงดึงลูกค้าเก่ากลับมาด้วย Broadcast ที่เขียนตัวอย่างข้อความมาให้ 2 แบบ และปิดด้วยช่วงสร้างเหตุผลให้สั่งซ้ำผ่านเมนูประจำสัปดาห์
ลักษณะคำตอบคือมีทั้งวิธีคิดและของที่หยิบไปใช้ได้ทันที เป็นระดับที่ Content Lead ที่ดีจะส่งมาให้ ซึ่งสำหรับร้านส่วนใหญ่ คำตอบของ Sonnet ตรงนี้ก็เพียงพอแล้วครับ
Opus 5.5 ไม่รีบตอบ แต่ตั้งสมมติฐานก่อนแล้วบอกว่าจะพิสูจน์ยังไง
Opus เริ่มด้วยการบอกว่ายอดตก 30% มีสาเหตุที่เป็นไปได้อย่างน้อย 3 ทาง คือจำนวนคนที่เปิดแชทลดลง อัตราการปิดการขายในแชทลดลง หรือยอดต่อออเดอร์ลดลง แล้วบอกว่าแต่ละสาเหตุต้องดูตัวเลขไหนเพื่อยืนยัน และถ้าเป็นสาเหตุนั้นควรแก้ยังไง พร้อมขอ Data เพิ่ม 2 อย่างก่อนจะฟันธง
ลักษณะคำตอบคือไม่ให้คำตอบสำเร็จรูป แต่ให้วิธีหาคำตอบที่ถูก ซึ่งถ้าเราเป็นเจ้าของร้านที่มี Data อยู่ในมือ Opus จะพาเราไปเจอสาเหตุจริงได้ แต่ถ้าเราไม่มี Data เลย คำตอบนี้อาจดูยืดยาวเกินความจำเป็นสำหรับร้านเล็กๆ
Fable 5.1 ตั้งคำถามกับโจทย์ก่อน แล้วชี้ Trade-off ที่คนถามยังไม่ได้คิด
Fable เปิดด้วยการตั้งข้อสังเกตว่ายอด LINE OA ที่ตกอาจไม่ใช่ปัญหา แต่อาจเป็นอาการของเรื่องอื่น เช่น ลูกค้าเดิมย้ายไปสั่งผ่าน Delivery App ที่ร้านเพิ่งเปิดรับ หรือลูกค้ากลับมาซื้อหน้าร้านเพราะอยู่ใกล้กว่าที่คิด ซึ่งถ้าเป็นแบบหลัง ยอดรวมอาจไม่ได้ตกเลย แล้วจึงชี้ว่าการทุ่มงบกู้ยอด LINE อาจไปแย่งลูกค้าจากช่องทางตัวเองที่กำไรดีกว่า ก่อนจะเสนอวิธีทดสอบแบบแยกกลุ่มลูกค้าเพื่อพิสูจน์ว่าสมมติฐานไหนจริง
ลักษณะคำตอบคือเปลี่ยนโจทย์ ไม่ใช่แค่ตอบโจทย์ ซึ่งเป็นระดับที่ Strategic Planner เก่งๆ จะทำ และเป็นเหตุผลว่าทำไม Fable ถึงคุ้มกับงานที่ผิดแล้วแพง แต่สำหรับคำถามง่ายๆ ที่เราแค่อยากได้ลิสต์ไปทำ Fable จะคิดเยอะและช้ากว่าที่เราต้องการครับ
เห็นไหมครับว่าทั้ง 4 ตัวไม่ได้มีใครตอบผิด แต่ตอบในระดับความลึกที่ต่างกัน และระดับที่เหมาะคือระดับที่พอดีกับสิ่งที่เราจะเอาไปทำต่อ ไม่ใช่ระดับที่ลึกที่สุดเสมอไป
Task to Model Mapping ตารางจับคู่งาน Marketing กับโมเดล Claude ที่เหมาะ
พอเห็นความต่างของคำตอบแล้ว ลองมาดูว่าถ้าเอาไปจับกับงานจริงที่นักการตลาดทำทุกวัน แต่ละงานควรลงที่โมเดลไหน ตารางนี้คือสิ่งที่ผมใช้เป็นแผนที่ของซีรีส์นี้ทั้งชุด โดยแต่ละแถวจะกลายเป็นบทความ 1 ตอนที่ลงรายละเอียดพร้อม Prompt 10 ตัวครับ
งาน Marketing โมเดลที่เหมาะ ทำไม Cleansing และ Tagging ข้อมูล Social Listening หลักหมื่นโพสต์ Haiku 4.5 โจทย์แคบ ปริมาณเยอะ ต้องถูกและเร็ว ตอบแชทและคอมเมนต์ลูกค้าแบบ Realtime Haiku 4.5 Latency สำคัญกว่าความลึก โพสต์ Social Media รายวัน และแตก Variation สำหรับ A/B Test Sonnet 5.5 งานมีโครงชัด ต้อง Iterate หลายรอบ เขียนบทความ SEO, Repurpose คอนเทนต์, ย่อยรายงานต่างประเทศ Sonnet 5.5 คุณภาพงานเขียนดี Context 1 ล้าน Token ตรวจงาน Data ที่ทีมส่งมา และสรุป Report Opus 5.5 ฉลาดพอโดยไม่คิดเยอะเกินงาน Routine Data Research Insight และ Campaign Post-Mortem Opus 5.5 เชื่อม Data หลายแหล่ง ทำงานยาวไม่หลุด Brand Strategy และ Positioning Fable 5.1 งานที่คิดผิดแล้วแพงกว่าค่าโมเดลหลายเท่า สังเคราะห์ Research หลายสิบชิ้นเป็น Thesis เดียว Fable 5.1 Reasoning หนักที่สุดในบรรดางานการตลาด
สังเกตว่าแต่ละโมเดลมีงาน 2 ประเภท และไม่มีงานไหนที่ต้องใช้ Fable เป็น Default เลย ซึ่งตรงกับคำแนะนำของ Anthropic เองที่ให้เริ่มที่ Opus 5.5 แล้วค่อยขยับขึ้นเมื่อจำเป็น และตรงกับที่ผมสังเกตจากการใช้งานจริงว่างานการตลาดราว 80% จบได้ที่ Sonnet กับ Opus ครับ
Effort Setting ปุ่มปรับความลึกที่คนใช้ผ่านแชทกับคนใช้ผ่าน API เห็นไม่เหมือนกัน
มีอีกชั้นหนึ่งที่หลายคนสับสน คือคำว่า Effort ระดับ low, medium, high, xhigh และ max ที่เห็นในเอกสารของ Claude ซึ่งผมขออธิบายสั้นๆ เพราะจะมีผลกับวิธีอ่านตอนถัดๆ ไปของซีรีส์
Effort คือตัวบอกโมเดลว่าควรใช้ Token ในการคิดมากแค่ไหนต่อคำตอบ ตามเอกสาร Effort ของ Claude Platform ระดับ high คือ Default ของโมเดลส่วนใหญ่ ยกเว้น Opus 5.5 ที่ Default อยู่ที่ medium ซึ่งเป็นจุดที่คนพลาดบ่อย คือใช้ Opus แล้วรู้สึกว่าตอบตื้นกว่าที่คาดในงาน Insight สำคัญ ทั้งที่แค่สั่งให้ขึ้นเป็น high ก็เปลี่ยนไปอีกระดับ
จุดสำคัญที่ต้องรู้คือ Effort เป็นค่าที่ตั้งได้ผ่าน API เป็นหลัก เช่น เวลาทีมทำ Pipeline วิเคราะห์ Social Data ที่รันอัตโนมัติ ส่วนการใช้งานผ่านแชทบน claude.ai ทั่วไป สิ่งที่เราเลือกได้คือโมเดล แล้วระบบจะปรับความลึกการคิดแบบ Adaptive ให้เอง ดังนั้นสำหรับคนที่ใช้แชทเป็นหลัก วิธีอัปเกรดคุณภาพคำตอบคือเปลี่ยนโมเดล ไม่ใช่หาปุ่ม Effort ครับ
และอีกเรื่องที่เอกสารเตือนไว้ตรงๆ คือ max ไม่ได้ดีกว่าเสมอ งานที่มีโครงสร้างง่ายๆ ถ้าสั่ง max อาจเจออาการคิดวนเกินโจทย์ ซึ่งเสียทั้งเวลาและเงินโดยไม่ได้คุณภาพเพิ่ม ในซีรีส์นี้ผมเลยจะระบุ Effort ที่แนะนำไว้ในแต่ละตอน สำหรับคนที่ใช้ผ่าน API เท่านั้น ส่วนคนใช้แชทให้ยึดที่ชื่อโมเดลได้เลย
The Series Map ซีรีส์ Claude Prompt สำหรับนักการตลาดทั้ง 8 ตอนที่จะตามมา
บทความนี้เป็นภาพรวม ส่วนรายละเอียดของแต่ละงานพร้อม Prompt 10 ตัวที่แต่ละตัวบอกทั้ง Tactic ที่ใช้ ทำไมโมเดลนี้ถึงตอบได้ดี และตัวอย่างผลลัพธ์ จะอยู่ในตอนถัดไปตามลำดับนี้ครับ
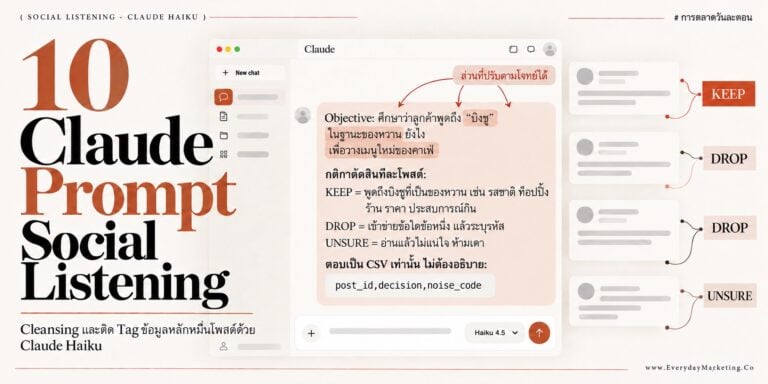
10 Claude Prompt Social Listening สำหรับนักการตลาด ทำ Cleansing และติด Tag ข้อมูลหลักหมื่นโพสต์ด้วย Claude Haiku 10 Claude Prompt ตอบแชทลูกค้าแบบ Realtime ด้วย Claude Haiku 10 Claude Prompt โพสต์ Social Media รายวันด้วย Claude Sonnet 10 Claude Prompt เขียนบทความ SEO และ Repurpose ด้วย Claude Sonnet 10 Claude Prompt ตรวจงาน Data และสรุป Report ด้วย Claude Opus 10 Claude Prompt Data Research Insight และ Campaign Post-Mortem ด้วย Claude Opus 10 Claude Prompt Brand Strategy วางกลยุทธ์แบรนด์ด้วย Claude Fable 10 Claude Prompt สังเคราะห์ Research เป็น Thesis ด้วย Claude Fable
สำหรับคนที่ยังไม่แน่ใจว่าตัวเองใช้ Claude ตัวไหนอยู่ หรือยังสับสนระหว่างแอปแชทกับเครื่องมืออื่นในตระกูลเดียวกัน ผมเคยเขียนอธิบายไว้ในบทความความต่างของ Claude, Claude Cowork, Claude Code และ Claude Design ส่วนใครที่อยากเห็นว่า Prompt การตลาดกับ Claude หน้าตาเป็นยังไง ลองเริ่มจากชุด Prompt หา Consumer Insight ด้วย Claude AI ที่เป็นซีรีส์ก่อนหน้าของเพจได้เลยครับ
Task-Model Fit สรุปวิธีเลือกโมเดล Claude ที่นักการตลาดเอาไปใช้ได้ตั้งแต่วันนี้
จากนี้ไปคำถามที่นักการตลาดอย่างเราควรถามก่อนพิมพ์ Prompt ทุกครั้ง น่าจะไม่ใช่ โมเดลไหนเก่งที่สุด แต่คือ งานนี้ผิดแล้วแพงแค่ไหน แล้วค่อยเลือกโมเดลที่พอดีกับราคานั้น งานเร็วและแก้ง่ายลง Haiku หรือ Sonnet งานวิเคราะห์ที่ส่งต่อให้คนอื่นตัดสินใจลง Opus และงานกลยุทธ์ที่จะอยู่กับแบรนด์ไปอีกหลายปีค่อยเรียก Fable
และสิ่งที่ผมอยากให้ลองทำจริงหลังอ่านจบ คือเลือกงานที่ใช้ AI ซ้ำบ่อยที่สุด 1 งาน แล้วลองรันด้วยโมเดลที่ต่ำกว่าที่เคยใช้ 1 ขั้น ถ้าผลไม่ต่าง คุณเพิ่งลดต้นทุนลงครึ่งหนึ่งโดยไม่เสียอะไรเลย แต่ถ้าผลต่างชัด คุณก็ได้หลักฐานว่างานนั้นสมควรจ่ายแพง ซึ่งทั้งสองคำตอบมีค่ากว่าการใช้ Default ไปตลอดทั้งคู่ครับ
ถ้าให้ผมรวบทั้งบทความนี้ให้เหลือคำเดียว คำนั้นคือ Task-Model Fit หรือการจับคู่งานกับโมเดลให้พอดี เหมือนที่นักการตลาดคุ้นกับคำว่า Product-Market Fit นั่นแหละครับ เพราะโมเดลที่ดีที่สุดไม่มีอยู่จริง มีแต่โมเดลที่พอดีกับงานตรงหน้า และถ้าคุณจับคู่ได้แม่น คุณจะได้ทั้งงานที่ดีกว่าและต้นทุนที่ถูกกว่าคนที่กดตัวบนสุดตลอดอย่างชัดเจนครับ